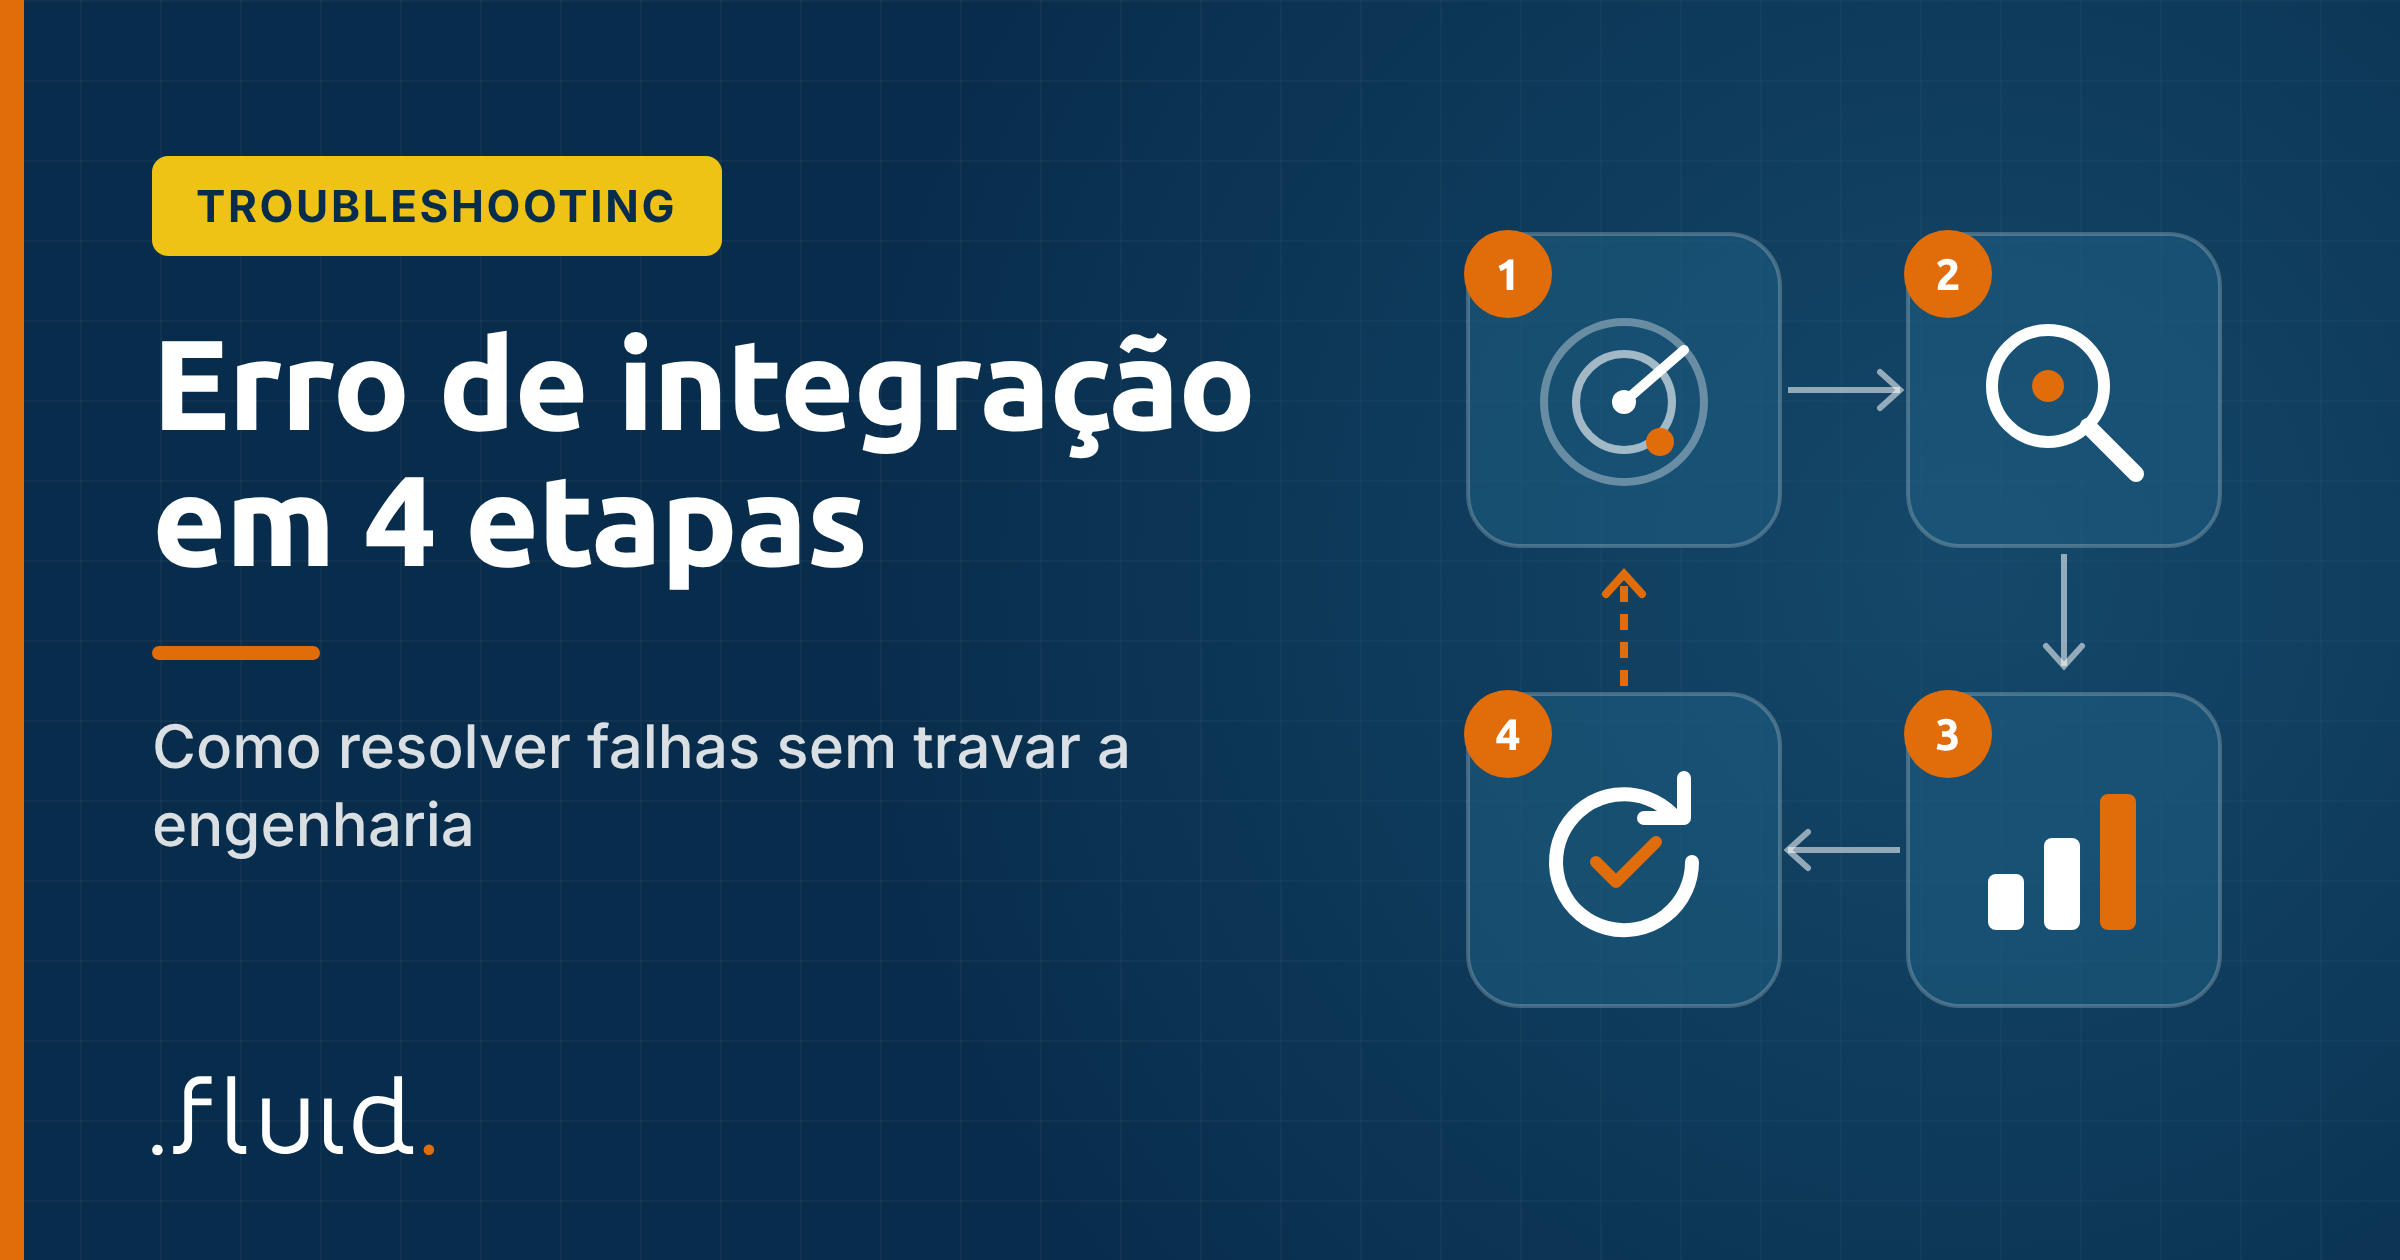
Resposta direta: para resolver um erro de integração, siga quatro etapas: detectar a falha antes do cliente, isolar a causa raiz, medir o impacto e só então corrigir e reprocessar com segurança. A maior parte dos erros recorrentes tem causa conhecida, como credencial expirada, limite de requisições ou campo mal mapeado. Por isso, com informação suficiente, o time de CS consegue resolver muitos deles sem abrir chamado para a engenharia.
Se você lidera produto ou plataforma em um SaaS B2B, provavelmente conhece a cena: um cliente avisa que os pedidos pararam de sincronizar, o suporte abre um chamado e alguém da engenharia larga a sprint para procurar o problema nos logs. Isso acontece toda semana. Este guia organiza esse trabalho em um roteiro repetível e mostra o que dá para tirar das costas da engenharia. Se quiser o contexto mais amplo, vale ler também sobre os desafios de integração que quase nunca entram no planejamento.
O que é um erro de integração
Um erro de integração é qualquer falha que impede que dados ou eventos passem corretamente de um sistema para outro: uma requisição recusada, um registro gravado incompleto ou um evento que nunca chegou ao destino.
O erro pode estar em três lugares: na origem (o dado saiu errado), no meio do caminho (transformação, mapeamento ou fila) ou no destino (a API recusou, estava fora do ar ou mudou de contrato). Saber em qual dos três pontos o problema nasceu já resolve metade da investigação. Para quem está começando a mapear essa arquitetura, ajuda entender a diferença entre APIs e uma plataforma de integração.
Por que erros de integração viram gargalo em um SaaS B2B
Em um SaaS B2B, cada cliente conecta o produto a um conjunto diferente de ERPs, CRMs e ferramentas. Com integrações embedded dentro do produto, o número de combinações cresce junto com a base de clientes, e o volume de erros cresce junto.
O problema não é só a quantidade. Quando não existe um processo claro, todo erro segue o mesmo caminho caro: cliente reclama, suporte escala, engenharia investiga. O tempo de resolução depende de quem está disponível, e não da complexidade real da falha. É assim que integrações começam a disputar espaço com o roadmap e geram um custo operacional que raramente aparece no planejamento.
O roteiro abaixo ataca exatamente isso: cada etapa produz a informação que a próxima precisa e deixa claro quem deve agir.
Etapa 1: detectar a falha antes do cliente
A primeira etapa do troubleshooting é saber que a falha aconteceu, de preferência antes que o cliente perceba. Se o seu time descobre erros pelo chamado do cliente, todas as etapas seguintes começam atrasadas e sob pressão.
Alerta com contexto, não só notificação
Um alerta útil responde, sem que ninguém precise abrir os logs: qual integração, qual cliente, qual etapa do fluxo, qual mensagem de erro e desde quando. Um e-mail dizendo apenas "falha na integração X" obriga alguém a investigar do zero, e esse alguém quase sempre é da engenharia.
Também vale agrupar alertas repetidos. Cem falhas iguais em uma hora são um incidente, não cem incidentes. Sem agrupamento, o time passa a ignorar os alertas, e aí um erro novo e diferente passa despercebido.
O risco das falhas silenciosas
Nem toda falha gera erro. Às vezes a requisição retorna sucesso, mas o dado chega incompleto, ou um webhook simplesmente para de chegar. Essas falhas silenciosas só aparecem se você monitorar também a ausência de atividade: uma integração que costuma processar centenas de eventos por dia e processou zero hoje merece um alerta, mesmo sem nenhum erro registrado.
Etapa 2: isolar a causa raiz
Isolar a causa raiz significa descobrir por que a falha aconteceu, e não apenas onde ela apareceu. A mensagem de erro do destino costuma mostrar o sintoma. A causa pode estar uma ou duas etapas antes.
Erros temporários e erros permanentes
A primeira pergunta é se o erro tende a se resolver sozinho. A documentação do Google Cloud Application Integration, por exemplo, separa erros temporários, ligados a indisponibilidade do lado do servidor, de erros permanentes, causados pela requisição em si, e recomenda políticas de nova tentativa só para os primeiros (fonte).
Na prática:
Erro temporário: destino fora do ar, timeout, limite de requisições atingido. Uma nova tentativa automática, com intervalo crescente entre as tentativas (backoff), costuma resolver.
Erro permanente: campo obrigatório ausente, formato inválido, credencial revogada. Repetir a mesma requisição vai falhar de novo. Alguém precisa corrigir o dado ou a configuração.
Tratar um erro permanente como temporário é um dos erros mais comuns: o sistema tenta de novo dezenas de vezes, consome cota da API e atrasa a correção de verdade.
Sintomas comuns e causas prováveis
| Sintoma | Causa provável | Tipo | Quem costuma resolver |
|---|---|---|---|
| HTTP 401 ou erro de token em todas as chamadas de um cliente | Token expirado ou acesso revogado pelo cliente no sistema de destino | Permanente até reautenticar | CS, orientando o cliente a reconectar |
| HTTP 429 (Too Many Requests) | Limite de requisições do destino atingido. O destino pode informar quanto tempo esperar no cabeçalho Retry-After (RFC 6585) | Temporário | Automático (retry com backoff). Engenharia se for recorrente |
| HTTP 5xx ou timeout | Instabilidade ou indisponibilidade do sistema de destino | Temporário | Automático. CS acompanha e comunica o cliente |
| HTTP 400 ou 422 com mensagem de campo inválido | Dado de origem incompleto ou mapeamento de campos errado | Permanente | CS, se o mapeamento for configurável. Engenharia, se for código |
| Erros começam de uma vez para todos os clientes de um conector | Mudança de versão ou de contrato na API de terceiro | Permanente | Engenharia ou dono do conector |
| Sucesso no envio, mas dado ausente ou duplicado no destino | Falha silenciosa, reprocessamento sem controle de duplicidade ou regra de negócio no destino | Varia | Engenharia investiga. CS levanta os registros afetados |
Para a linha de credenciais, vale aprofundar em gestão segura de credenciais em integrações.
Etapa 3: medir o impacto antes de corrigir
Medir o impacto é responder a três perguntas antes de mexer em qualquer coisa: quais registros foram afetados, desde quando e em quais clientes. Sem essas respostas, a correção resolve o próximo evento, mas deixa para trás os que já falharam.
Essa etapa também define a prioridade. Um erro que afeta um campo opcional de um cliente pode entrar na fila normal. Um erro que impede a emissão de notas fiscais de dezenas de clientes é um incidente e precisa de comunicação proativa. Ter a lista de registros afetados em mãos também muda a conversa com o cliente: em vez de "estamos investigando", o CS pode dizer "identificamos 42 pedidos afetados entre 9h e 11h e vamos reprocessá-los" (número ilustrativo).
Para isso, o registro de execuções precisa permitir consulta por registro individual, e não só por execução. "A execução das 10h falhou" é pouco. "O pedido 1234 falhou na etapa de mapeamento por falta do CNPJ" é o que permite agir.
Etapa 4: corrigir, reprocessar e verificar
A última etapa tem três partes: corrigir a causa, reprocessar os registros afetados e confirmar que eles chegaram ao destino. Pular a verificação é o motivo mais comum para o mesmo chamado voltar dias depois.
Reprocessar com segurança
Reprocessar é enviar de novo os registros que falharam, depois da correção. O risco é a duplicidade: se parte dos registros já tinha chegado ao destino, reenviar tudo pode criar pedidos ou cobranças em dobro.
A proteção contra isso é a idempotência: a propriedade de uma operação que produz o mesmo resultado mesmo quando executada mais de uma vez. Na prática, isso significa usar um identificador único por registro, para que o destino reconheça e ignore um envio repetido. Também significa reprocessar apenas os registros que constam como falha, e não a execução inteira.
Registros que falham repetidamente devem sair do fluxo principal e ir para uma fila separada, conhecida como fila de mensagens mortas (dead-letter queue, ou DLQ). Assim eles não bloqueiam o restante e podem ser analisados com calma.
Quando não reprocessar
Nem todo registro com falha deve ser reenviado. Antes de reprocessar, confirme:
se a causa foi corrigida (senão o registro falha de novo);
se o dado ainda é válido (um pedido cancelado na origem não deve ser criado no destino);
se a ordem importa (atualizar um cadastro antes de criá-lo gera outro erro);
se o cliente já fez a correção manualmente no destino.
Quem resolve cada tipo de erro: CS ou engenharia
A divisão de trabalho que mais alivia a engenharia é simples: o CS resolve o que é configuração e dado, e a engenharia resolve o que é código e contrato de API. Para isso funcionar, o CS precisa de acesso ao histórico de execuções, à mensagem de erro por registro e a uma forma segura de reprocessar.
| Tipo de problema | CS resolve quando tem | Vai para a engenharia quando |
|---|---|---|
| Credencial expirada ou revogada | Fluxo de reconexão que o próprio cliente executa | A autenticação falha mesmo com credenciais novas |
| Campo inválido ou ausente | Visibilidade do registro e mapeamento configurável | A transformação está em código |
| Destino indisponível | Status do retry automático e previsão para o cliente | As tentativas se esgotam ou o problema dura horas |
| Registros afetados por um incidente já corrigido | Reprocessamento seletivo pela interface | Não há controle de duplicidade |
| Mudança na API de terceiro | Identifica o padrão e escala com contexto | Sempre |
Repare que a coluna da esquerda depende muito mais de ferramenta do que de conhecimento técnico. A maioria dos times de CS consegue resolver esses casos. O que falta, em geral, é a informação.
Onde a IA ajuda no troubleshooting de integrações
Assistentes de IA conectados aos logs de execução podem acelerar as etapas 2 e 3: resumir centenas de falhas em poucos padrões, sugerir a causa provável e listar os registros afetados em linguagem simples. Protocolos como o MCP (Model Context Protocol) permitem que um assistente consulte esses dados de forma estruturada.
A IA, no entanto, não substitui as decisões das etapas 3 e 4. Reprocessar registros financeiros ou fiscais muda dados no sistema do cliente, e essa ação precisa de regras claras: quem pode autorizar, quais registros podem ser reenviados e como tudo fica registrado. A IA funciona melhor como camada de investigação, dentro de um processo governado, do que como executor sem supervisão.
Como a Fluid apoia esse roteiro
A Fluid é uma plataforma de integrações embedded e orquestração para SaaS B2B. No contexto deste roteiro, a plataforma oferece monitoramento centralizado de integrações e rastreabilidade de fluxos em tempo real. Ela também tem suporte a MCP em produção, o que permite conectar assistentes de IA aos dados da plataforma.
consulta de execuções e erros por registro individual;
reprocessamento seletivo pela interface, sem código, feito pelo time de CS;
alertas com contexto (integração, cliente, etapa, mensagem);
fluxo de reconexão de credenciais feito pelo próprio cliente final.
O objetivo é que integrações deixem de ser um gargalo do roadmap e passem a funcionar como parte do produto, com operação que não depende da engenharia para cada erro.
Perguntas frequentes
Qual a diferença entre erro de integração e erro de API? Um erro de API é a resposta de falha de uma chamada específica, como um HTTP 400 ou 500. Um erro de integração é mais amplo: inclui erros de API, mas também falhas de mapeamento, de fila e de regra de negócio, além de falhas silenciosas, em que nenhuma API retorna erro.
Toda falha de integração deve ser reprocessada automaticamente? Não. O reprocessamento automático faz sentido para erros temporários, como timeout, indisponibilidade e limite de requisições. Erros permanentes, como dado inválido ou credencial revogada, falham de novo até que a causa seja corrigida.
O que é backoff exponencial? É uma estratégia de nova tentativa em que o intervalo entre as tentativas aumenta a cada falha, por exemplo 1, 2, 4 e 8 segundos. Isso dá tempo para o sistema de destino se recuperar e evita sobrecarregá-lo com repetições.
Como evitar duplicidade ao reprocessar? Use um identificador único por registro, para que o destino reconheça envios repetidos, e reprocesse apenas os registros que constam como falha, nunca a execução inteira sem checagem.
Próximo passo: descubra o nível de maturidade das suas integrações
Se você reconheceu seu time na cena do início, com o cliente avisando primeiro e a engenharia investigando tudo, vale medir onde você está antes de decidir o que mudar. O Mapa de Maturidade de Integrações da Fluid avalia, entre outros pontos, como o seu time detecta falhas e quanta autonomia o CS tem para resolvê-las. Faça o diagnóstico de maturidade das suas integrações.
Quer ver a Fluid na sua arquitetura?
Em uma demo, mostramos como orquestrar seus sistemas, APIs e agentes de IA com governança.