Resposta direta: monitorar integrações em um SaaS B2B significa acompanhar três grupos de sinais. O primeiro é técnico (latência, volume, erros e saturação). O segundo é de ciclo de vida (credenciais, versões de API e webhooks). O terceiro é de negócio (registros sincronizados e atraso). Esses sinais precisam ser vistos por cliente e por conector, e cada alerta precisa chegar a quem consegue agir: engenharia, CS ou o próprio cliente.
Quando as integrações fazem parte do produto, uma falha deixa de ser um problema técnico interno e passa a ser uma falha do produto aos olhos do cliente. Mesmo assim, muitos times só descobrem que algo quebrou quando o cliente abre um chamado. Este guia mostra o que medir, como recortar os dados e como montar alertas que alguém consegue resolver, para que integrações deixem de gerar o custo que integrações mal resolvidas geram no SaaS.
Monitoramento e observabilidade de integrações: qual a diferença
Monitoramento responde a perguntas que você já sabe fazer: a taxa de erro passou do limite? A fila está crescendo? Observabilidade é a capacidade de responder a perguntas novas a partir dos dados que o sistema produz, como "por que só os pedidos deste cliente falham desde terça-feira?".
Na prática, os dois andam juntos. O monitoramento usa métricas e alertas para avisar que algo mudou. A observabilidade usa logs detalhados e o rastreamento de cada execução (traces) para explicar o porquê. Padrões abertos como o OpenTelemetry organizam esses dados em sinais como logs, métricas e traces.
Para integrações, a regra prática é: o monitoramento diz qual integração e qual cliente estão com problema, e a observabilidade diz em qual registro e em qual etapa.
Por que monitorar integrações embedded é diferente de monitorar uma API
Monitorar a sua própria API é olhar para um serviço que você controla. Monitorar integrações embedded dentro do produto é olhar para centenas de conexões entre o seu produto e sistemas que você não controla, cada uma configurada por um cliente diferente.
Isso muda três coisas:
A média esconde o problema. Uma taxa de erro global de 0,5% (exemplo ilustrativo) pode significar que um cliente importante está com 100% das sincronizações falhando. Por isso os dados precisam ser vistos por cliente.
A causa costuma estar fora. Um ERP fora do ar, um token revogado pelo cliente ou uma mudança na API de um parceiro causam falhas que não aparecem nos seus servidores.
Mais gente precisa ver. Além da engenharia, o CS precisa saber o que dizer ao cliente, e muitas vezes o próprio cliente precisa ver o status da conexão para resolver sozinho, por exemplo reconectando uma conta.
Os sinais que todo SaaS B2B deve monitorar nas integrações
Os sinais que valem a pena acompanhar se dividem em três grupos: técnicos, de ciclo de vida e de negócio. Os técnicos mostram se as chamadas funcionam. Os de ciclo de vida antecipam falhas que ainda não aconteceram. Os de negócio mostram se o cliente está recebendo o que espera.
Sinais técnicos: latência, tráfego, erros e saturação
O livro de SRE do Google define quatro sinais de ouro para monitorar sistemas: latência (tempo para atender uma requisição), tráfego (demanda sobre o sistema), erros (taxa de requisições que falham) e saturação (o quanto o recurso mais limitado está ocupado) (Google SRE Book). O mesmo texto lembra que um erro pode ser implícito, como uma resposta HTTP 200 com o conteúdo errado.
Aplicados a integrações, os quatro sinais ficam assim:
| Sinal | O que medir na integração | Exemplo de alerta |
|---|---|---|
| Latência | Tempo de cada chamada ao sistema externo e tempo total do fluxo, em percentis (p95, p99) e não só na média | O p95 do conector de ERP dobrou na última hora |
| Tráfego | Execuções e registros processados por cliente e por conector | Cliente que processa centenas de eventos por dia está sem nenhum há 3 horas |
| Erros | Taxa de falha por cliente, conector e tipo de erro (autenticação, validação, indisponibilidade) | Mais de 5% de falhas de validação em um cliente na última hora (limite ilustrativo) |
| Saturação | Tamanho e idade das filas, uso da cota de requisições (rate limit) do sistema externo | Consumo de 80% da cota diária da API de um parceiro antes do meio-dia |
Repare na linha de tráfego: a ausência de atividade é um dos alertas mais úteis, porque pega falhas que não geram nenhum erro.
Sinais de ciclo de vida: credenciais, versões de API e webhooks
Os sinais de ciclo de vida antecipam falhas que ainda não aconteceram. Eles são os mais ignorados e os que mais geram incidentes evitáveis.
Credenciais: tokens perto de expirar, renovações que falharam e acessos revogados. Saber com dias de antecedência que a credencial de um cliente vai vencer permite avisar o cliente antes da falha. Para aprofundar, veja como funciona a gestão segura de credenciais.
Versões de API: avisos de depreciação e datas de desligamento de versões usadas pelos conectores. Uma mudança de versão em um parceiro afeta todos os clientes daquele conector ao mesmo tempo.
Webhooks: assinaturas expiradas, endpoints que deixaram de responder e quedas no volume de eventos recebidos.
Sinais de negócio: registros sincronizados e atraso
Sinais de negócio medem a integração do ponto de vista do cliente: quantos registros chegaram ao destino e com quanto atraso. Uma integração pode ter zero erros técnicos e, mesmo assim, entregar dados com horas de atraso ou incompletos.
Dois exemplos que valem acompanhar:
Registros sincronizados x esperados: quantos pedidos, notas ou contatos saíram da origem e quantos chegaram ao destino no mesmo período.
Atraso da sincronização: quanto tempo se passou entre o evento na origem e a gravação no destino. É o número que o cliente sente, mesmo sem saber o nome.
Como recortar os dados: por cliente, por conector e por fluxo
O mesmo dado precisa ser visto em três recortes, porque cada um revela um tipo diferente de problema:
Por cliente: mostra problemas de configuração, credencial ou dado de um cliente específico. É o recorte que o CS mais usa.
Por conector: mostra problemas que afetam todos os clientes de uma mesma integração, como uma mudança de API ou uma instabilidade do sistema externo. É o recorte da engenharia e do dono do conector.
Por fluxo e etapa: mostra onde, dentro da integração, a falha acontece (autenticação, transformação, envio). É o recorte da investigação.
Uma boa regra: se os erros aparecem em muitos clientes de um conector ao mesmo tempo, comece pelo conector. Se aparecem em um cliente em vários conectores, comece pelo cliente.
Como montar alertas que alguém consegue resolver
Um bom alerta de integração é aquele que chega a quem pode agir, com contexto suficiente para agir sem precisar investigar do zero. O livro de SRE do Google resume o princípio: todo alerta deve ser acionável e deve exigir julgamento humano. Se a resposta é sempre a mesma ação mecânica, ela deveria ser automatizada (Google SRE Book).
Na prática, isso se traduz em quatro regras:
Alerte sobre sintomas, e investigue as causas. "O cliente X não sincroniza pedidos há 2 horas" é um sintoma que importa. "A CPU subiu" raramente é.
Inclua o contexto no alerta: integração, cliente, etapa, tipo de erro, desde quando e quantos registros foram afetados.
Agrupe repetições. Cem falhas iguais são um incidente, não cem alertas.
Automatize o que é mecânico. Erros temporários, como indisponibilidade e limite de requisições, devem ser tentados de novo automaticamente. O alerta só dispara quando as tentativas se esgotam.
Quando o alerta dispara, entra o processo de correção. Detalhamos esse processo no roteiro para diagnosticar e resolver um erro de integração.
Quem precisa ver cada sinal: engenharia, CS e cliente final
Cada público precisa de uma visão diferente. Mostrar tudo para todos gera ruído, e esconder tudo atrás da engenharia gera chamados.
| Público | O que precisa ver | Para quê |
|---|---|---|
| Engenharia e plataforma | Sinais por conector, latência em percentis, saturação, avisos de versão de API, traces detalhados | Corrigir conectores, ajustar capacidade e se antecipar a mudanças de parceiros |
| CS e suporte | Status por cliente, erros com mensagem clara, registros afetados, opção de reprocessar | Resolver casos de dado e configuração e comunicar o cliente com precisão |
| Cliente final (dentro do produto) | Status da conexão, última sincronização, aviso de credencial expirada com botão de reconectar | Resolver sozinho o que depende dele, sem abrir chamado |
| Liderança de produto | Tendência de incidentes por conector, tempo médio de resolução, chamados de integração por mês | Decidir onde investir: qual conector refazer e qual processo mudar |
A linha do cliente final é a que mais reduz chamados. Um aviso claro de "sua conexão com o ERP expirou, clique para reconectar" resolve, sem envolver ninguém, uma das causas mais comuns de falha.
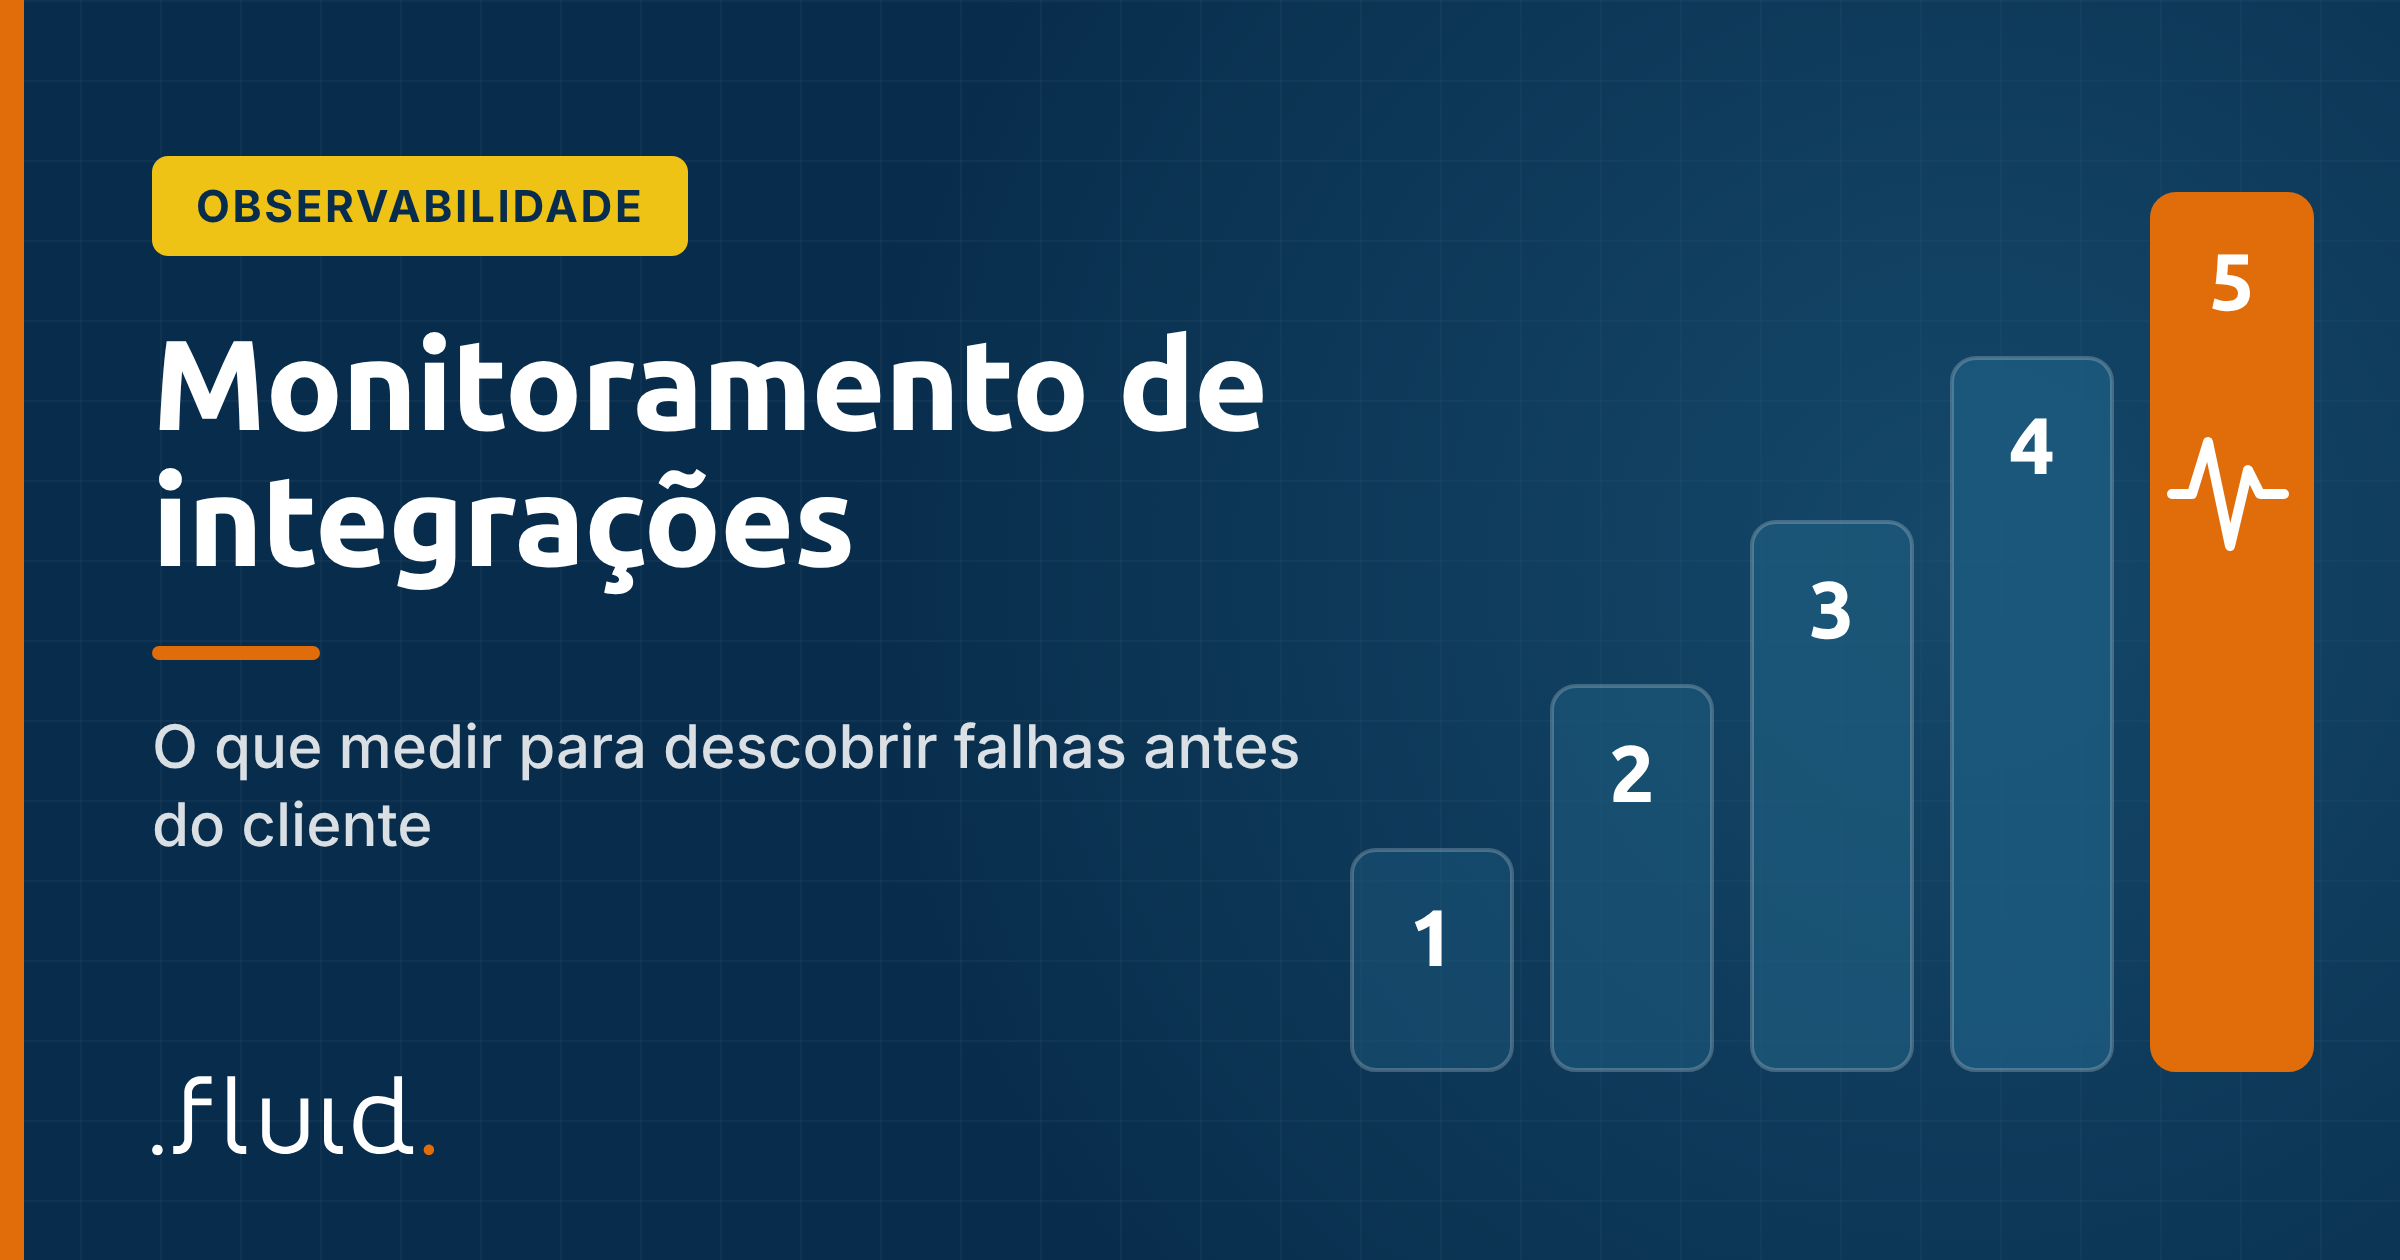
Os cinco níveis de maturidade do monitoramento de integrações
O Mapa de Maturidade de Integrações da Fluid classifica em cinco níveis a forma como um time descobre que uma integração falhou. Saber em que nível você está ajuda a escolher o próximo passo, em vez de tentar implementar tudo de uma vez.
O cliente abre o ticket. O time descobre a falha pelo cliente.
Revisão manual de logs. Alguém da engenharia confere os logs de tempos em tempos.
Alertas básicos. Existem alertas por e-mail, mas sem contexto suficiente para resolver.
Dashboard parcial. Há visão centralizada, mas alguns casos ainda exigem investigação manual da engenharia.
Alertas automáticos com saúde em tempo real. Os sinais são vistos por cliente e conector, os alertas trazem contexto e chegam a quem pode agir.
Para a maioria dos times, o salto de maior impacto é do nível 1 ou 2 para o 3 ou 4: sair do "descobrimos pelo cliente" já muda a relação com o cliente e com a engenharia (interpretação editorial).
Construir o monitoramento internamente ou usar uma plataforma
As duas opções fazem sentido em cenários diferentes. A decisão depende de quantos conectores você mantém, de quantos clientes os usam e de quanto tempo de engenharia você pode dedicar a isso.
Construir internamente tende a fazer sentido com poucos conectores, um time de plataforma com experiência em observabilidade e necessidades muito específicas. O custo está na manutenção: cada novo conector precisa ser instrumentado, e as visões para CS e cliente final costumam ficar para depois.
Usar uma plataforma de integração com monitoramento nativo tende a fazer sentido quando o número de conectores e clientes cresce, e quando CS e cliente final precisam de autonomia. A troca é aceitar o modelo de dados e as visões da plataforma.
Em qualquer dos casos, o critério de avaliação é o mesmo: os sinais deste guia estão disponíveis por cliente e por conector, e chegam a quem pode agir? Para entender como esse gargalo aparece com a escala, vale ler como SaaS B2B lidam com o gargalo de escala nas integrações.
Como a Fluid apoia o monitoramento de integrações
A Fluid é uma plataforma de integrações embedded e orquestração para SaaS B2B, criada para que integrações deixem de ser gargalo do roadmap e passem a funcionar como parte do produto. A plataforma oferece gestão centralizada de integrações com monitoramento e rastreabilidade de fluxos em tempo real. Também tem suporte a MCP (Model Context Protocol) em produção, o que permite conectar assistentes de IA aos dados da plataforma.
visão por cliente e por conector;
alertas configuráveis com contexto;
monitoramento de expiração e renovação de credenciais;
status da conexão visível para o cliente final, dentro do produto;
reprocessamento pelo time de CS.
Perguntas frequentes
Qual a diferença entre monitorar uma API e monitorar uma integração? Monitorar uma API é acompanhar um serviço específico: latência, erros e disponibilidade. Monitorar uma integração é acompanhar o fluxo completo entre dois sistemas, incluindo credenciais, filas, transformações e o resultado de negócio, como registros que chegaram ao destino.
Quais métricas de integração devo acompanhar primeiro? Comece pela taxa de erro por cliente e por conector, pelo volume de registros processados (para detectar ausência de atividade) e pelas credenciais perto de expirar. Esses três sinais cobrem boa parte das falhas que chegam ao cliente.
O que são os quatro sinais de ouro? São latência, tráfego, erros e saturação, definidos no livro de SRE do Google como os sinais mínimos para monitorar um sistema voltado a usuários. Em integrações, eles são medidos por chamada externa, por cliente e por conector.
Monitorar integrações exige uma ferramenta de observabilidade separada? Não necessariamente. Ferramentas gerais de observabilidade cobrem bem os sinais técnicos. Os recortes por cliente e conector, os sinais de negócio e as visões para CS e cliente final costumam exigir instrumentação específica ou uma plataforma de integração que já os ofereça.
Próximo passo: descubra em que nível está o seu time
Antes de escolher ferramentas, vale saber de onde você está partindo. O Mapa de Maturidade de Integrações da Fluid avalia como o seu time detecta falhas, quanta autonomia o CS tem e como vocês gerenciam credenciais e mudanças de API. No fim, você recebe um recorte do nível atual. Descubra o nível de maturidade das suas integrações.
Quer ver a Fluid na sua arquitetura?
Em uma demo, mostramos como orquestrar seus sistemas, APIs e agentes de IA com governança.